hoàng đế cởi truồng

Cuối cùng cũng đã có một người can đảm nói lên sự thật: hoàng đế cởi truồng !!! A.I. dạng LLM là hoàn toàn không có khả năng thông minh như con người! Nó chỉ xào xáo ngôn từ như một con vẹt, bên trong không hề có tí cấu trúc logic, không hề có một chút suy luận nào! Như trước đây tôi đã từng đưa ví dụ, dùng Google A.I. để tìm thông tin của một thiết bị điện tử, nó trả về các thông số: thiết bị tiêu thụ dòng điện 6 Amp, và có cầu chì 5 Amp (!!!) Cầu chì 5 Amp mà cấp dòng điện 6 Amp thì có phải là sẽ cháy ngay lập tức không, nhưng… A.I. không tự biết điều đó!

LLM – Large language model, về bản chất đó là một ANN – Artificial neural network – mạng nơ-ron siêu lớn, một mô hình máy học mang tính thống kê cố đi tìm mối liên hệ giữa các cụm từ. Đừng để bị đánh lừa bởi từ ngữ, nói là mạng nơ-ron nhưng chẳng có cái nơ-ron thần kinh thực nào đâu! Về World Model, mô hình “thế hệ mới” được cho là có khả năng “mô phỏng thế giới vật lý”, đây cũng chỉ là… thêm một cái ANN nữa mà thôi. Còn về “thế giới thực”: cảm nhận, kinh nghiệm, tri giác, nhận thức… đó là những gì thì đến nay, đến bản thân con người vẫn còn chưa biết rõ nữa là A.I.

ảo giác A.I. – A.I hallucination

Con người dùng ngôn ngữ tự nhiên để giao tiếp, để mô tả thế giới xung quanh! Nhưng tất cả các ngôn ngữ tự nhiên, dù ngữ pháp chặt chẽ đến đâu, cũng có nhiều điểm yếu, mà yếu nhất là tính logic, tính cấu trúc và tính trình tự. Nhiều khi, rất nhiều người học được một mớ ngôn từ, nhưng không thực sự hiểu nội dung bên trong, họ tự tạo ra một cái “ảo giác hiểu biết – hallucination”! Về điều này thì A.I. hiện nay cũng giống y hệt như con người, và chúng ta có thể dùng “tấm gương” A.I. đó để tự tìm hiểu xem, phải chăng chúng ta cũng có rất nhiều “ảo giác” suốt bấy lâu nay!?

Một ví dụ là “Trương Định & Trương công Định”, chữ Hán “Trương công Định” là ý nói: ông (công) họ Trương, tên Định. Vì không hiểu cái cú pháp “xxx-công-yyy” này nên nhiều người Việt tự tạo ra một cái ảo giác, bịa ra nhân vật không có thật mang cái tên “Trương Công Định”. Do tiếng Việt mượn từ tiếng Hoa một số lớn từ vựng, câu chữ nên những “ảo giác” do hiểu sai chữ Hán phải nói là… Hằng hà sa số, không đếm hết! Và “ảo giác” từ cả ngàn năm nay chứ không phải gần đây! Những bạn đọc trên blog này có thể tìm thấy rất nhiều ví dụ trong các post trước.

Cũng tương tự vậy, “Lê thị A”, “Nguyễn thị B” là dạng “ảo giác” đã phổ biến đến mức người Việt chấp nhận đó là… hiển nhiên! Xưa đi học, từ cấp 1 cho tới… cấp 4, tôi có thể dễ dàng nhận ra nhiều dạng “ảo giác” này: tự cho là mình hiểu một điều gì đó, nhưng thực chất hoàn toàn không phải vậy. Những người thông minh đôi khi mất vài ngày, vài tuần để nhận ra chỗ sai. Nhưng cũng có rất nhiều người suốt đời chỉ thu lượm được toàn các loại ảo giác, không tự nhận thức ra được! Nên mới nói: ngôn ngữ vừa là công cụ trợ giúp tư duy, cũng vừa là… dẫn hướng lầm lạc!

Ngày xưa, việc tạo ra các “ảo giác hiểu biết” khi tiếp cận nguồn Hán học là một hiện tượng vô cùng phổ biến, đến mức nhiều người nói “nhăng cuội” theo kiểu “bùa chú”, nói mà không hề hiểu mình đang nói cái gì! Những tưởng vì chữ Hán khó học mới thành ra vậy, hóa ra đến khi tiếp cận nguồn Tây học rồi cũng y chang thế, lâu lâu lại xuất hiện vài ku “ngáo nặng” kiểu: ‘Thuyết hấp dẫn mới’ của Bùi Minh Trí, hay rất nhiều các thể loại “triết học” khác! Đó là chưa kể một bộ phận lớn người Việt cố tình tạo ra các “ảo giác hiểu biết” chỉ để làm màu, lòe người, hay để đi bịp người khác!

Hiện tượng “ảo giác” xảy ra khi con người (hay máy móc) tìm được một liên hệ mang tính thống kê giữa các cụm từ, từ đó dẫn tới giả định rằng giữa những cụm từ đó có một mối quan hệ logic, hay là truyền tải một nội dung nào đó. Đó là sản phẩm của những đầu óc ngây ngô, giản đơn kiểu như con nít, chưa từng được đào luyện qua những tập ngữ vựng (corpus) rộng lớn, phức tạp! Nôm na tức là họ chỉ nhớ được một số từ vựng cơ bản, rồi vì một động cơ nào đó, tự suy diễn, tự bịa ra những nội dung tào lao mà bên trong não bộ không hề có bất kỳ sự tự vấn, kiểm chứng nào!

Với máy móc, đó đơn thuần là do “hạn chế kỹ thuật”, các lý do “phần cứng, phần mềm” hay là do “dữ liệu” chưa đủ. Với con người, ngoài lý do “phần cứng, phần mềm”, quá trình học vấn, rèn luyện ra, lý do lớn hơn là… “do tâm”! Là do cái tâm cuồng loạn, không có công phu tìm hiểu, học hành điều gì cho tử tế, nhưng lại cứ muốn thể hiện! Dưới những áp lực xã hội quá lớn, cái tâm trở nên bất chấp, tự nó tưởng tượng ra những thứ gọi là “hiểu biết, trí thức”, tự nó hoang tưởng đến mức cố cùng! Về điều này thì GS. Cao Xuân Hạo đã viết một bài về chứng “vĩ cuồng” rất đáng đọc!

Tuy vậy, hiện tượng “vĩ cuồng” mà GS. Cao Xuân Hạo đã đề cập đến là tương đối cá biệt, ít xảy ra, còn hiện tượng “vi cuồng” mà post này đang nói tới, thì đối lập lại, chính là từ trong những “ảo giác hiểu biết” dẫn đến cái “chấp ngã”, “ta là đúng”, “ta hơn người”, dẫn tới những cái tôi đấu đá, kình chống nhau, bày ra đủ trò lưu manh lặt vặt, rồi tiếp tục dẫn tới những kiểu cá tính “mãi không chịu lớn” rất thường thấy trong xã hội ngày nay. “Vi cuồng” gây ra những hậu quả thảm khốc hơn “vĩ cuồng” rất nhiều, vì nó phổ quát, sâu rộng đến mức đã trở thành một kiểu “dân tộc tính”!

Chính vì ngôn ngữ lỏng lẻo, nghèo nàn và tùy tiện nên đẻ ra những kiểu người chỉ biết có “ảo giác”, “giả tri thức”, bất kỳ lúc nào cũng có thể trở nên “nguy hiểm”! Các ngôn ngữ có tính cấu trúc cao tự bản thân nó đã có lợi thế nhất định, khi ép buộc người dùng ngôn ngữ vào khuôn khổ của những cấu trúc logic nhỏ, giúp loại bớt đi một phần các “ảo giác hiểu biết”. Cũng chính vì tự ý thức được những yếu kém trong ngôn ngữ nên người TQ rất chú trọng tính chi tiết, kỹ càng và tính kỷ luật trong giáo dục, thậm chí đẩy sự rèn luyện này đến mức khắc nghiệt!

Đó là nói những ngôn ngữ tính cấu trúc yếu như tiếng Việt, còn những ngôn ngữ có tính cấu trúc mạnh như tiếng Anh, Pháp, Nga… thì sao!? Thì cũng y như vậy mà thôi, chỉ là ở một cấp độ cao hơn, phức tạp hơn. Hiện tượng “ảo giác” trong thế giới khoa học, công nghệ, lập trình là… nhan nhãn. Một ví dụ là “async / await”, tự cho rằng mình tìm ra được cách giải quyết vấn đề mới, thực chất còn chưa hiểu được các vấn đề lập trình song song kiểu cổ điển. Kết quả là không hề tạo ra được một giải pháp mới nào, tự bịa ra một loại cú pháp dư thừa vô ích, mà dư thừa tức là có hại!

A.I, đó chỉ là một khái niệm tập hợp (umbrella term) bao gồm vô số thể loại khác nhau! Có những loại A.I. làm những công việc phức tạp, tạo ra những kết quả kỳ diệu, những loại đó thường không nói gì, thậm chí không mấy ai biết đến! Còn cái loại như LLM – sinh ra là để nói nhiều, thì rõ ràng không hiểu được bao nhiêu! A.I. như kiểu LLM, chính là một cái gương phản chiếu thế giới con người, con người thế nào, não trạng như thế nào thì tạo ra được loại A.I. giống y như thế! Chỉ là một tấm gương phản ánh con người mà thôi, thậm chí còn là một tấm gương méo mó!

Nhiều loại A.I. thực sự hữu dụng thường… không tự nhận mình là A.I., thậm chí cố tránh không sử dụng thuật ngữ A.I. Còn những loại đi đâu cũng… “ta đây A.I.” chính thực là những mô hình LLM “to mồm” nhưng “rỗng tuếch”. Chỉ có thiểu năng mới cho rằng ChatGPT, OpenAI… là có “hiểu biết”, bất quá chỉ là những công cụ giúp tìm kiếm, sắp xếp thông tin mà thôi, thông tin chính xác tới đâu vẫn còn chưa bàn tới! Chỉ có ngu xuẩn mới cho rằng cần ứng dụng ChatGPT, OpenAI… vào giáo dục, nhất là ở các cấp sơ học, hay bản thân còn cảm thấy chưa đủ “ảo giác”?

Mục tiêu của giáo dục không phải là biết được những gì, tích lũy được bao nhiêu thông tin. Mục tiêu của giáo dục là giúp xây dựng nên cách thức tư duy, suy nghĩ! Cách nhanh nhất để hủy hoại đầu óc một con người là làm anh ta “bão hòa” với một mớ thông tin vô bổ, tạo ra những “ảo giác hiểu biết”, và rồi cứ thế lặp lại như con vẹt vậy, chứ không thực sự hiểu được nội hàm bên trong. Và đó cũng là cách mà các nước tiên tiến tìm cách “nô dịch” các dân tộc chậm tiến, anh chỉ việc “biết như thế” thôi, biết như thế là đủ rồi, còn tôi sẽ tạo ra những cái để cho “anh biết”!

lại A.I.

A.I. – trí tuệ nhân tạo, đó là một thuật ngữ rất chung chung, ám chỉ vô số thể loại khác nhau. Có những loại như Wolfram Alpha chuyên giải toán, có những hệ thống chuyên về xử lý, nhận dạng hình ảnh / video, đây đều là những hệ thống phần mềm siêu phức tạp, có quá trình phát triển tính bằng nhiều thập kỷ, có những cái đã bắt đầu làm từ cách đây… hơn 50 năm! Cũng có những loại LLM (large language model) mới xuất hiện gần đây chuyên về xử lý ngôn ngữ tự nhiên – NLP. Và cũng giống như rất nhiều “người sáng tạo nội dung” trên mạng xã hội Việt vậy, các mô hình LLM nói chuyện gần giống con người, nhưng hoàn toàn không có chút trí tuệ nào.

Bên trong các mô hình LLM không có các cấu trúc logic nhỏ, nó chỉ bắt chước cách nói chuyện như con vẹt mà thôi! Và vì không có logic nên rất thường khi, như người ta hay nói: anh không mở miệng ra thì không ai biết anh ngu, nhưng anh mở miệng nói ra rồi thì… người ta chẳng còn nghi ngờ gì nữa!!! Cũng chính vì lý do đó mà các hệ thống tìm kiếm có A.I. hỗ trợ, như Google thường ngu xuẩn một cách vô lý, và sự ngu xuẩn này thường khi là vô cùng “aggressive”, luôn tỏ ra “ta đây cái gì cũng biết”, xen vào những lĩnh vực chuyên môn, chuyên ngành, thậm chí tìm cách áp đặt những “kiến thức” do tự nó tưởng tượng ra chứ hoàn toàn không có thật.

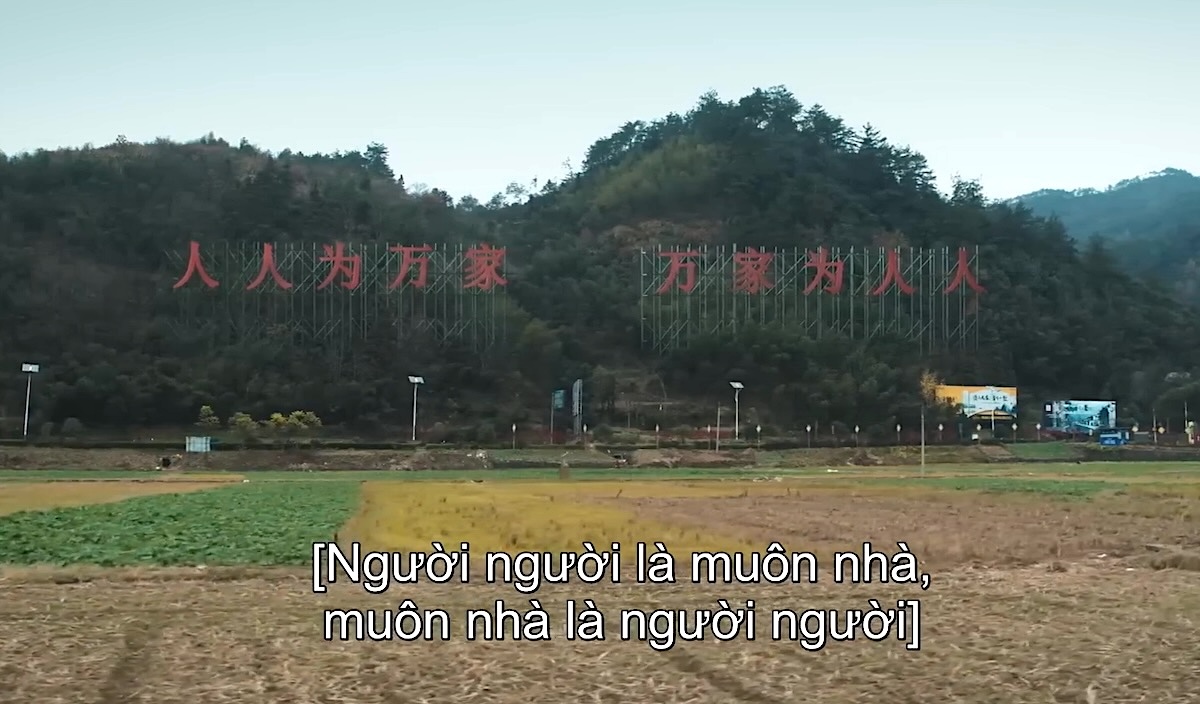
Đây thực chất là cách các nước phát triển tìm cách “dắt mũi, lừa bịp, nô dịch” các dân tộc chậm tiến, khi chỉ cần vài ba dòng ba hoa, thiểu năng cũng muốn đi bịp thiên hạ, chuyện đời đâu có dễ dàng như vậy! Thậm chí ngay cả trong chuyện xử lý ngôn ngữ tự nhiên thì các hệ thống A.I. hiện tại cũng chưa có khả năng hiểu được những câu cú đơn giản nhất, chưa nói đến văn chương, điển cố hay các câu chữ tinh tế, phức tạp khác. Như cái vietsub – phụ đề Việt ngữ dưới đây cũng vậy, câu này phải hiểu đúng là: “Mọi người vì Vạn gia, Vạn gia vì mọi người”, chữ “vi” này có nhiều nghĩa: vì, là, làm, nhưng chọn nghĩa nào thì… A.I. không tự luận ra được!

Các cách sử dụng A.I. để “dịch” phụ đề các phim nước ngoài, từ tiếng Trung, tiếng Anh sang tiếng Việt đều ngu xuẩn như thế! Mới chỉ là những câu thoại đơn giản là đã có vấn đề rồi, còn những nội dung vi tế, sâu xa thì hầu như không truyền tải được! Thực chất, điều này không thể trách A.I. hoàn toàn, vì đến người sợ là dịch cũng mới ngang cỡ đó. Hơn 2000 năm, mượn người ta không thiếu thứ gì, đến độ tập từ vựng dễ có hơn 90% là từ gốc Trung, nhưng chỉ mượn một mớ từ ngữ trên bề mặt để bịp nhau mà thôi, chứ không học được nội dung, công phu bên trong! Thế rồi vỗ ngực ta đây: cùng Hán Đường Tống Nguyên mỗi bên hùng cứ một phương…

Bất định và tất định

Hơn 20 năm trước có đọc một cuốn sách tựa là “Fooled by randomness – Bị làm cho khùng bởi tính ngẫu nhiên” – Nassim Nicholas Taleb, sách rất hay! Tác giả phê phán vô số kiểu Xác suất thống kê dùng trong kinh tế, xem đó như là một thứ giả-khoa-học – pseudo-science! Muốn biết nó giả như thế nào thì cứ xem báo cáo GDP – PPP hàng năm của VN sẽ rõ, xem các bác ấy làm “pháp thuật” với các con số một cách vô cùng ảo diệu!

Tuy XSTK cơ bản vẫn là một nhánh của toán học, vẫn có tác dụng mô tả thế giới thực, nhưng cần phải nói là, phần nhiều các công thức XSTK dùng trong kinh tế chỉ có tính chất mô tả, gần đúng, xấp xỉ thô, thậm chí, nhiều trường hợp vẫn còn là… giả định, giả thuyết, dùng được tới đâu còn tùy ngữ cảnh. Mà một đặc tính tâm lý mang tính chất “cố hữu” của con người là: càng nghĩ nhiều về chuyện gì thì… càng thấy mình đúng!

Vì càng ngày tôi càng phải đúng, “cái tôi” càng lúc càng trở nên “tuyệt đối”, nên càng nghĩ nhiều thì càng đi vào bế tắc tâm lý! Phần nhiều các vị dùng XSTK cũng y như vậy, xài công thức, công cụ, lý thuyết xác suất thống kê gì càng nhiều thì… càng tự thuyết phục mình rằng nó đúng, nó phải đúng! Đó là một kiểu sai lầm chết người mà tác giả Taleb đã chỉ ra rất rõ, tuy cách nói năng của ông ta rất gay gắt, không khoan nhượng!

Từ đó đến nay hơn 20 năm, không ai phản bác được Taleb câu nào, dù cách nói năng của ông ta làm nhiều người ghét. Cứ như thế, cái tranh cãi rằng thế giới này vận hành theo những quy luật “tất định” (determinism) có thể đoán biết trước, hay tất cả chỉ là những sự kiện “bất định” (Trẻ Tạo hóa đành hanh quá ngán, Chết đuối người trên cạn mà chơi) mãi mãi vẫn sẽ là tranh cãi, như đã được chỉ rõ bởi Hệ thức bất định Heisenberg!

Nhưng… con người mà, the matter of randomness is too important to be left to chance – vấn đề các sự kiện ngẫu nhiên là quá quan trọng để có thể phó thác nó… cho sự ngẫu nhiên (!!!) :D Con người vẫn tìm cách nắm bắt nó theo một cách nào đó. Nào là VaR – value at risk, nào là LaR – Liquidity at Risk, và tất cả những phương pháp XSTK khác đều có một số “giả định” ban đầu, là giả… định đấy, đừng cố chấp tin là thực!

programming

Rất lâu về trước, dễ đã đến nhiều thập kỷ, có một thời mà, khi mở một cuốn “Cẩm nang lập trình” tiêu biểu ra, câu đầu tiên nó nói cho bạn biết là… Lập trình là một nghề cao quý… Nhưng các cuốn cẩm nang của thời hiện đại bây giờ, theo đà lạm phát giá trị, đã không còn thấy có câu đó nữa! :) Thay vì tập trung vào các “logic nhỏ”, hiểu vấn đề cho thấu đáo, các “cẩm nang” hiện đại ưa chuộng sử dụng từ “công nghệ” hơn, cứ toàn ở trên mây thôi!

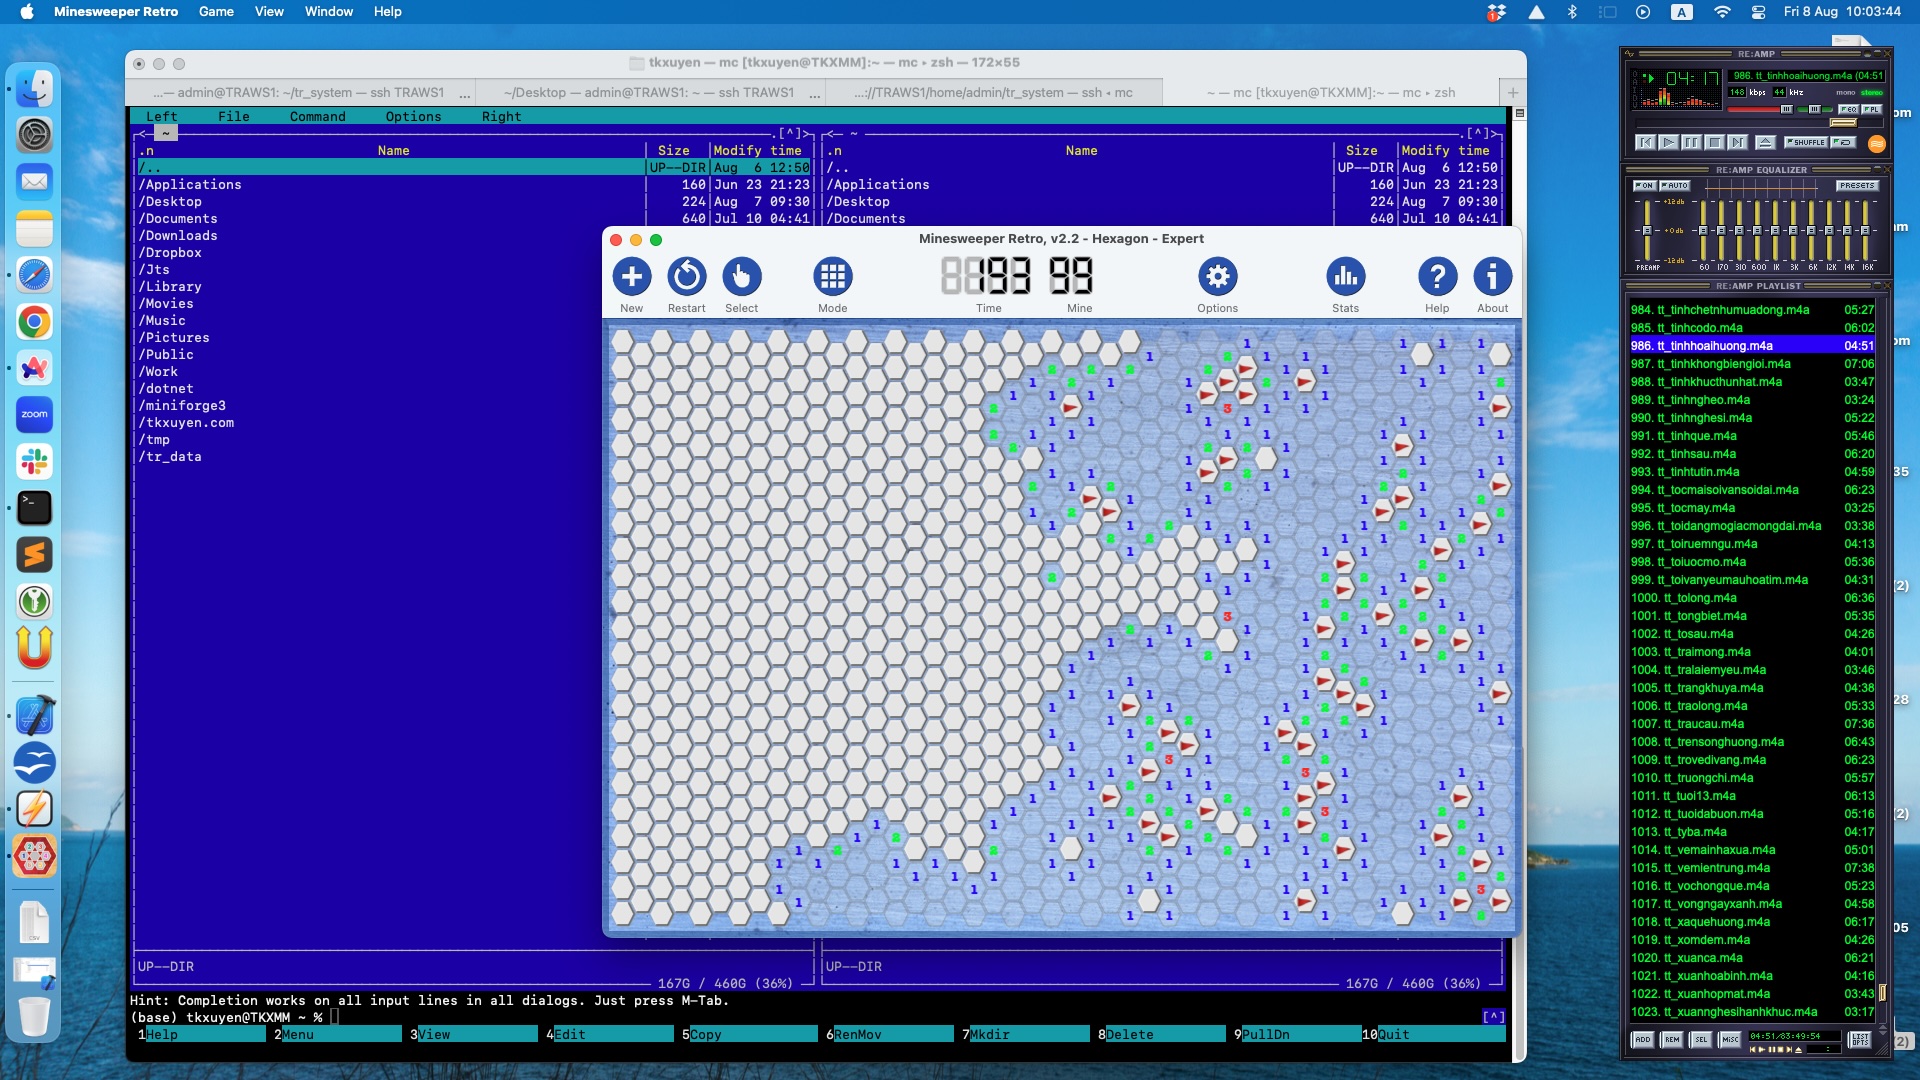
Thay vì tìm niềm vui trong những điều căn bản, nhỏ nhặt, các “cẩm nang” hiện đại gieo rắc những ảo tưởng rất hàm hồ về những trào lưu mới trên bề mặt… Một trong khá nhiều game tự viết để… tự chơi, trò gỡ mìn xưa cũ với các ô thay vì hình vuông kiểu truyền thống thì có thể tùy chọn là các hình tam giác, ngũ giác, lục giác, bát giác, etc… Đến giờ vẫn chơi Minesweeper, vẫn xài Norton Commander và Winamp như một cái thời… muôn năm cũ xa xưa ấy!

tidal analysis, 2

Như thế ta thấy từ những tò mò, băn khoăn nhỏ dẫn đến những bước tiến lớn… như kiểu bị quả táo rụng vào đầu vậy! Vấn đề thủy triều gây ra nhiều quan tâm ở châu Âu, đặc biệt là ở Anh và Pháp, nơi thủy triều cao và thấp có thể chênh nhau đến hơn 7, 8 mét và gây ra những hệ quả nghiêm trọng! Từ Newton, Laplace, đến Fourier, nhiều nhà toán học, vật lý học đã nghiên cứu về thủy triều. Đặc biệt sau khi Fourier chỉ ra rằng bất kỳ một hàm tuần hoàn nào, dù phức tạp đến đâu, cũng đều có thể được phân giải thành tổng của các hàm lượng giác tuần hoàn đơn giản có dạng f(t) = A cos(vt + p), tức là phân giải một tần số thành tổng của nhiều tần số con. Mà những tần số con này đều đã biết trước trong bài toán thủy triều, ví dụ như với mặt trăng (M2), tần số là khoảng 24.8333, vì trái đất quay (biểu kiến) quanh mặt trăng mất khoảng 24h 50 phút. Đã biết trước hầu hết các tham số, chỉ phải tính A – amplitude, biên độ nữa mà thôi.

Không khó để chứng minh rằng, tích phân của hàm g(t) x f(t) chia cho thời gian t chính là biên độ dao động A, với g(t) là hàm thủy triều và f(t) là hàm cosine đại diện cho mức độ ảnh hưởng của mặt trăng. Việc còn lại là thu thập dữ liệu lên xuống của thủy triều, bỏ vào trong cái máy tính tích phân, nhân nó với các hàm cosine và tính ra các hệ số tương ứng! Và chính là từ bài toán phân tích và dự đoán thủy triều, mà dẫn đến một loạt các phát kiến, phát minh, dẫn đến các hệ máy tính cơ học đầu tiên, dẫn đến các hệ thống tính toán và tự động hóa khác… Nhắc lại một câu chuyện tiếu lâm đã kể mấy năm trước, một người Anh bị quả táo rụng vào đầu, thế là ông ta đã phát minh ra định luật vạn vật hấp dẫn! Một người Trung Quốc bị quả táo rụng vào đầu, ông ta liền trồng cả một nông trại táo rộng lớn và bán các sản phẩm táo đi khắp thế giới. Một người VN… à không, anh ta đã bị một quả dừa to rụng vào đầu từ rất lâu về trước… :D

ball and disk integrator

Trong hình là một cái máy tính tích phân cơ khí, cơ chế hoạt động như sau: đĩa tròn quay với vận tốc không đổi, đại diện cho trục x, thường là thời gian t, đĩa quay làm quả bi tròn quay theo! Tùy theo vị trí của bi mà tốc độ quay khác nhau, nếu bi ở chính ngay tâm đĩa, thì tốc độ là 0, bi không xoay, nếu bi được di chuyển ra càng gần mép đĩa thì tốc độ quay càng nhanh hơn, nếu di chuyển ngược lại về phía bên kia đĩa thì bi sẽ quay theo chiều ngược lại. Bi xoay làm cho trục tròn nằm ngang xoay theo, nếu ta di chuyển bi qua lại dọc theo đồ thị của một hàm số f(x) thì, không quá khó để hình dung, số vòng quay tích lũy của trục chính là tích phân của hàm f(x), nói một cách đơn giản chính là diện tích phần ‘nằm bên dưới’ đường cong f(x).

Chỉ cần đếm số vòng quay của trục thì sẽ nhận được giá trị của tích phân này. Căn bản đó chỉ là một cái máy tính tích phân cơ học, nhưng ứng dụng thì quá quan trọng đến nỗi người ta cho rằng đây là thiết bị quan trọng nhất từng được chế tạo trước khi máy tính điện tử ra đời! Máy chỉ thị mục tiêu và dẫn bắn trên chiến hạm Dreadnought là sử dụng cơ chế đĩa và bi, máy tính dẫn bắn cho các loại ngư lôi trong WW2 là dạng bi và đĩa, máy quan sát ném bom – Norden bombsight cũng là dạng bi và đĩa, và vô số máy móc, thiết bị khác. Hình là máy phân tích thủy triều chế tạo bởi Sir Kelvin (William Thomson), đĩa không chuyển động tròn đều mà chuyển động hình sin, nhưng căn bản, đây chính là máy tính tích phân đầu tiên!

tidal analysis

Thủy triều được dự đoán, tính toán như thế nào? Vì có quá nhiều tham số tác động đến thủy triều, như M2 (moon) hay S2 (sun), và nhiều hành tinh khác, nên dự đoán thủy triều được bắt đầu bằng việc… thu thập, ghi chép số liệu thực nghiệm tại một cảng nào đó, số liệu này được thu thập trong nhiều năm và sau đó dùng một phép biến đổi Fourier để phân tích hàm thủy triều (số liệu) này thành tổng của các hàm lượng giác con, mỗi hàm con có dạng f(t) = A x cos(st + p), với A (amplitude) là độ lớn, biên độ dao động, s (speed) là vận tốc góc, p (phase shift) là độ lệch pha, và t là thời gian. Mỗi hàm lượng giác điều hòa con này là đại diện cho mức độ ảnh hưởng của một yếu tố riêng biệt, như mặt trời, mặt trăng, các hành tinh, etc…

Nhưng ngày xưa chưa có máy tính điện tử, người ta phân tích Fourier như thế nào? Cũng lại là dùng các máy tính cơ học, trong ảnh là máy phân tích thủy triều được chế tạo bởi Sir Kelvin (William Thomson) năm 1878, máy dài 6m. Sau khi đã phân tích dữ liệu quá khứ đã thu thập và có được các tham số thì lại nhập các tham số này vào máy dự đoán thủy triều (đã nói ở bài trước) để tính thủy triều tại một thời điểm cụ thể nào đó trong tương lai. Về máy phân tích thủy triều thì có nhiều chuyện phức tạp, nhưng về máy dự đoán thủy triều, cơ chế vận hành của nó lại khá đơn giản. Hình thứ 2 là cơ chế máy dự đoán thủy triều, hàng bánh xe trên là cố định, hàng bánh xe dưới có thể chỉnh được tốc độ, độ lớn cũng như độ lệch pha!

Chính là biểu diễn các tham số A, s và p trong công thức nói trên. Sau đó thông qua những cái “Scotch yoke” (cái này không biết phải dịch ra tiếng Việt thế nào) để biến chuyển động quay thành chuyển động tịnh tiến, kéo các ròng rọc chạy! Nguyên hệ ròng rọc chạy và kéo một sợi dây, sợi dây này kéo một cây bút trên bề mặt một băng giấy xoay tròn, vẽ thành đồ thị thay đổi lên xuống của thủy triều theo thời gian. Hàm tổng (thủy triều) được tổng hợp lại từ các hàm con đơn giản như thế! 150 năm trước người ta đã tìm cách phân tích và tổng hợp chính xác, 150 năm sau, chúng ta tổ chức giải đua ghe, nhưng rút cuộc không đua được vì còn phải chờ đến “giờ lành” để bắt đầu, đến “giờ lành” thì nước triều đã rút cạn chỉ tới đầu gối!

duck test

Mấy năm trước, có sự kiện một người làm thiết kế – designer sử dụng “AI”… đương nhiên AI hiểu trong ngữ cảnh thiết kế tức là “Adobe InDesign” chứ không phải là “Artificial Intelligence”, nhưng mấy ku “nhà báo thiểu năng” VN thì chớp được đúng một chữ AI, vội vàng tán láo thế này thế kia, đến nhiều ngày sau còn chưa hiểu ra được mình ngu chỗ nào. Những ví dụ dạng này là… hằng hà sa số, mang tiếng là con người, nhưng trí thông minh chưa bằng được máy, các hệ thống AI bây giờ có thể phân biệt ngữ cảnh khá tốt! Và đến tận bây giờ vẫn thế, tràn đìa trên mặt báo, viết câu tiếng Việt đơn giản không thông, ngoại ngữ đọc không hiểu, nhưng suốt ngày la liếm khắp nơi, chỗ nào cũng có mặt, vấn đề nào cũng hiểu, tạo ra một đám bụi mù thông tin, kích động người này người khác đánh nhau.

Có một bài kiểm tra trong giới CS (computer science) gọi là “Duck test – kiểm tra vịt”: nếu nó đi lạch bạch như vịt, bơi như vịt, và kêu quác quác như vịt, thì chắc chắn nó là vịt rồi. Hay như một chính trị gia Mỹ: tôi không biết hắn ta có phải là CS (cộng sản) không, nhưng một con chim chân có màng, bơi như vịt, kêu quác quác như vịt thì chắc là vịt rồi? Hay gần đây hơn, ngoại trưởng Larov nhận xét các nhóm Hồi giáo thân Tây phương, như một kiểu châm biếm: nhìn giống như khủng bố, nói năng như khủng phố, đánh đấm như khủng bố, vậy chắc chắn là khủng bố rồi!? Cái gọi là AI – artificial intelligence, dù vượt qua được Turing-test, nhưng đến nay vẫn không thể nào vượt qua được Duct-test và Chinese-room-test để có thể chứng minh là có tư duy thật sự, thì rồi cũng chỉ là “vịt” mà thôi!

Đến một lúc, ta sẽ thấy, cái gọi là AI, hay chí ít là các thể loại “AI hạ cấp, tào lao”, chính là phản ảnh cái “não trạng” của cái cộng đồng sử dụng nó! Thậm chí còn tệ hơn cả wikipedia, trên wiki, ít ra còn có người này người kia, phe này phe kia đánh nhau, tranh dành nhau chỉnh sửa nội dung, ít ra còn có sự đấu đá, tranh luận qua lại, thể hiện các luồng suy nghĩ đối lập nhau. Còn “AI”, ít nhất là các phiên bản “đại chúng, phổ thông” chính là một kiểu “núp lùm” và “đội lốt”, nó đưa quan điểm, ý kiến như thể được rút ra từ khoảng không vậy, mà cái khoảng không này, xui rủi thay, chính là phản ánh sự “vô tri, thiểu năng” của cái cộng đồng xài nó, ai cũng là “tác giả” mà đồng thời, cũng không có ai là “tác giả” cả, không một ai đứng ra chịu trách nhiệm về tính đúng đắn của nguồn tin, của suy nghĩ!

AI, 2

Hơn 25 năm trước, hồi đang còn ngồi trên ghế nhà trường, Bộ môn Trí tuệ nhân tạo, Khoa CNTT, ĐH KHTN… tôi có xài một cái chương trình tên là Eliza, dạng chương trình chat, mình gõ một câu, nó trả lời một câu, hoàn toàn command-line: “- Hi, how are you today!? – Thanks, but I don’t feel very well”, câu chuyện bắt đầu như thế, vì không muốn khởi đầu có vẻ rập khuôn nên tôi trả lời không được khỏe lắm… Nói chuyện một hồi lâu, sau nó hỏi: “- How do you feel now? – I feel better now!” Thế là cái chương trình máy tính kia nó văng ra một câu làm mình sững sờ: “You’ve felt better cause you’ve been talking with me!” – Anh đã cảm thấy tốt hơn là do nói chuyện với tôi nãy giờ đó!!! Đó là lần đầu tiên, cũng là lần cuối cùng tôi xài Eliza! Không phải là vì “sợ” cái trí thông minh của nó…

Mà vì không muốn bận tâm bởi những câu trả lời, mà tôi nghĩ là, nó có một bộ thư viện hàng chục ngàn câu có thể khiến cho bạn phải “ngạc nhiên”, oh, hóa ra máy tính “thông minh” đến vậy! Tư duy của con người, đó là phân tích độc lập, tìm tòi, liên hệ, hình dung, tưởng tượng, đến cả những loại tư duy bằng hình ảnh, âm thanh chứ không phải chỉ bằng ngôn từ, nếu chỉ lặp lại một số lượng lớn ngôn từ theo dạng “thiểu năng” thì con người không thể bằng máy, bắt so với máy khác nào bắt con cá phải leo cây! Chốt lại một điều là: A.I. có xu hướng lặp lại cái “não trạng” của cộng đồng, cộng đồng như thế nào thì họ sẽ có được thứ A.I. giống như thế, giống như thứ họ muốn có mà thôi! Một cái hang trống hoác vang vọng trở lại những cái thế giới nội tâm cũng trống hoác giống y như thế!